Aktiver Kontext
Was das Modell gerade vor sich hat
Die konkrete Eingabe eines Modellaufrufs: Auftrag, bereitgestellte Historie, ausgewählte Erinnerungen, Werkzeugverträge und Ergebnisse. Dieser Ausschnitt ist durch das Kontextfenster begrenzt.
EVE verbindet ein Sprachmodell mit einem dauerhaften, belegbaren Gedächtnis. Sie kann Arbeitsstände wieder aufnehmen, Wissen gezielt abrufen und vorhandene Handlungserfahrungen für neue Anfragen nutzen.
Das Modell interpretiert den Auftrag und wählt aus veröffentlichten Werkzeugen. Die Runtime führt diese Aufrufe aus, liefert Ergebnisse zurück und protokolliert den Ablauf. Arbeitslisten und Nova sind inzwischen über MCP angebunden; andere Fähigkeiten haben ihre jeweiligen nativen Schnittstellen. Die Gedächtnisdaten liegen lokal in data/eve.db. Web und Nova können externe Dienste ansprechen.
Die konkrete Eingabe eines Modellaufrufs: Auftrag, bereitgestellte Historie, ausgewählte Erinnerungen, Werkzeugverträge und Ergebnisse. Dieser Ausschnitt ist durch das Kontextfenster begrenzt.
Persistente Arbeitsräume mit Originaldaten, Bildern, Referenzen, Notizen, Aufrufjournal und modellformuliertem Checkpoint. „Kurzzeit“ heißt hier vorübergehender Zweck – nicht ausschließlich RAM.
Strukturierte Aussagen und Erfahrungen mit Herkunft, Gültigkeit und Beziehungen. Dazu gehören Nutzerpräferenzen, Anweisungen, Gerätebindungen und belegte Beobachtungen.
Die Chat-Historie ist zusätzlich das Gesprächsarchiv. Eine gespeicherte Chatnachricht ist nicht automatisch ein als gültig übernommener Memory-Claim.
Die Originale werden vor weiteren Modellaufrufen gesichert. Große Inhalte können im aktiven Kontext durch Datenbankreferenzen ersetzt werden. EVE kann gezielt Teile nachlesen und einen Arbeitsstand als Checkpoint speichern. Ein neuer Modellkontext erhält den Originalauftrag, den verfügbaren Checkpoint und Verweise auf das Journal. So bleibt der Auftrag fortsetzbar, ohne sämtliche alten Ergebnisse erneut in den Prompt zu kopieren.
| Aktuelle Bereinigung | Aufbewahrung | Was das bedeutet |
|---|---|---|
| Erfolgreich abgeschlossene Arbeitsstände | 1 Stunde | Nach letztem Zugriff, bei der nächsten Bereinigung. |
| Fehlgeschlagene / abgebrochene Arbeitsstände | 24 Stunden | Material zur Untersuchung und Wiederaufnahme bleibt länger verfügbar. |
| Abgeschlossenes temporäres Lernmaterial | 15 Minuten | Eigene technische Aufbewahrungsklasse. |
| Angeheftet, laufend oder ungeklärter Aufruf | Geschützt | Keine automatische Entfernung durch diese Kurzzeitbereinigung. |
Prüfintervall aktuell: 15 Minuten, außerdem beim Start. Diese Regeln löschen nicht pauschal die Chat-Historie oder das Langzeitgedächtnis. Für Langzeitbelege benötigte Beobachtungen können erhalten bleiben.
Beispielsweise eine Präferenz, eine Ressourcenbindung oder eine beobachtete Eigenschaft. Dazu kommen Geltungsbereich, Nutzdaten, Status und gegebenenfalls ein Gültigkeitszeitraum.
Verweis auf eine Nutzernachricht oder ein konkretes Werkzeugergebnis. Unterstützung und Widerspruch werden getrennt erfasst. Ein Modelltext allein beweist keine ausgeführte Handlung.
Verknüpfungen zwischen Aussagen, etwa „ersetzt“, „verfeinert“ oder eine Verbindung zu einer Handlungsrepräsentation. Herkunft und Entwicklung bleiben nachvollziehbar.
Neue Belege können bestehende Aussagen unterstützen, ihnen widersprechen oder eine konkurrierende Aussage begründen. Ersetzen und Verfeinern sind eigene dokumentierte Übergänge. Im normalen aktuellen Abruf werden Kandidaten, ungültige und nicht mehr aktuelle Aussagen herausgefiltert; historische und Audit-Abfragen können andere Sichten verwenden.
Der Memory-Compiler stellt eine passende Sicht aus dem vorhandenen Wissen zusammen: mit Geltungsbereichen, Lebenszyklus, Zeitbezug, strukturierten Daten, Wortsuche und Beziehungen. Daneben bietet memory.find lexikalische Suche, Embedding-Suche und deren hybride Kombination. Die konfigurierten mehrsprachigen Embeddings werden lokal berechnet. Eine Suchrangliste ist keine vollständige Bestandsaufnahme; dafür gibt es strukturierte Inventarabfragen.
Aktive, gültige und wortgetreu belegte Nutzeranweisungen mit applicability=always werden unabhängig vom aktuellen Suchthema bereitgestellt. Die übrigen Erinnerungen bleiben an die jeweilige Auswahl gebunden. Gespeicherte Gerätezustände sind historische Beobachtungen; sie sind kein frischer Live-Status.
Nach der sichtbaren Antwort wird der abgeschlossene Gesprächsschritt als dauerhafter Lernauftrag vorgemerkt. Der Hintergrundkoordinator wartet aktuell 120 Sekunden Leerlauf und verarbeitet bis zu 8 Turns pro Batch. Neue Interaktion erhält Vorrang; laufende Lernarbeit kann dafür unterbrochen werden.
Fehlgeschlagene Lernversuche bleiben sichtbar. Sie können gezielt erneut versucht oder nach tatsächlicher Prüfung als „geprüft“ markiert werden; geprüfte Fehler werden nicht wieder automatisch zum Lernen eingeplant. „Nichts speichern“ ist dagegen ein reguläres Ergebnis.
Zusätzliche aktive Pfade: Das Modell kann bereits während der Bearbeitung strukturierte semantische Erfahrungen schreiben (Abschnitt 07). Erfolgreiche native Providerantworten können bereits während der Bearbeitung belegte Schnittstellenerfahrungen speichern, etwa Anfragestruktur und Antwortform. Das ist etwas anderes als eine allgemein gültige Handlungsregel.
Ein Fakt könnte lauten: „Diese Ressource ist eine Lampe.“ Eine semantische Handlungserfahrung verbindet dagegen eine Formulierung mit einer interpretierten Absicht, erforderlichem Kontext, einem Provider, einem konkreten Plan und dem beobachteten Ergebnis.
„Was wurde bei diesem konkreten Auftrag als Handlung verstanden und ausgeführt?“ Sie enthält Formulierung, Kontextbedingungen, technische Schritte, Ergebnisse, Bestätigungen und Widersprüche.
Eine gemeinsame Darstellung für Erfahrungen, die als dieselbe gemeinte Handlung zugeordnet wurden. Gleiche technische Aufrufdaten allein beweisen noch keine gleiche Bedeutung.
Die Module unterscheiden ausdrücklich technischen Erfolg und semantische Bestätigung. Ein erfolgreiches Werkzeug kann das falsche Gerät angesprochen haben. Explizite Rückmeldung kann eine konkrete Erfahrung bestätigen oder widerlegen. Für bestimmte automatische Freigaben müssen unabhängige, konsistente Erfahrungen mit strukturierter Modellbewertung und erfolgreicher Providerprüfung vorliegen. Eine engere exakte Freigabe ist im Modul ebenfalls vorgesehen; sie autorisiert keine Ähnlichkeitsübertragung.
| Baustein | Was er beiträgt | Was er nicht beweist |
|---|---|---|
| Embedding-Suche | Findet thematisch bzw. bedeutungsbezogen passende Texte im Wissen. | Dass eine Geräteaktion gemeint oder autorisiert ist. |
| Explizite Sprachbeziehungen | Gespeicherte Gleichsetzungen, Abgrenzungen, Formulierungs- und Ressourcenbezüge. | Beliebige zusätzliche Synonyme oder uneingeschränkte Übertragbarkeit. |
| Dynamische Semantik | Sucht eine ausreichend passende Formulierung zu einer gültigen Handlungserfahrung. | Eine prozentuale Wahrscheinlichkeit, den Nutzer richtig zu verstehen. |
| Differenzielle Komposition | Kombiniert einzeln belegte Zuordnungen von Sprachmerkmalen zu Planfeldern. | Dass schon ein Beispiel oder ähnliche Wörter für eine neue Aktion ausreichen. |
Die Sprachmodule können ausdrücklich erklärte Gleichsetzungen oder Abgrenzungen speichern – schematisch etwa „Mit A und B meine ich dasselbe“ oder „A und B sind verschieden“. Die referenzierten Formulierungen müssen im belegten Nutzertext vorkommen. Ressourcen-Aliase beziehen eine Bezeichnung auf einen Providerbezug. Daneben kann eine belegte Handlungsrepräsentation mit einem technischen Ausführer verbunden werden, etwa einer passenden Home-Assistant-Szene. Diese Beziehungen tragen eigene Herkunft und Geltungsbedingungen; sie sind keine eingebauten Synonymlisten.
Der implementierte Abgleich normalisiert formale Wortmerkmale, ordnet Wörter unabhängig von ihrer Reihenfolge zu und bewertet strukturelle bzw. Zeichenähnlichkeit. Explizite positive und negative Beziehungen können diese Zuordnung beeinflussen. Eine negative Beziehung kann einen Treffer ausschließen; mehrere konkurrierende Handlungsrepräsentationen ergeben keinen eindeutigen Treffer.
Aktuell ist dieser Mechanismus auf active mit Schwelle 0,85 konfiguriert. Dieser Wert ist ein formaler Vergleichswert, keine „85 % Bedeutungsgewissheit“. Die Embeddings der Memory-Suche sind ein anderer Mechanismus.
Die Komposition vergleicht kompatible Handlungserfahrungen mit gleicher Planstruktur. Sprachmerkmale werden Planfeldern gegenübergestellt. Besonders aussagekräftig sind Kontrastpaare: Bei ansonsten gleichen technischen Feldern ändert sich genau ein Feld – etwa der Dienst oder die Ressourcen-ID.
Licht Küche an  → Küche · einschalten
Licht Küche aus → Küche · ausschalten
Licht Flur an   → Flur  · einschalten
Licht Flur aus  → Flur  · ausschalten
… weitere unabhängige Erfahrungen
an → bestimmter Dienstwert
aus → anderer Dienstwert
Küche / Flur → jeweiliger Ressourcenbezug
Vereinfachtes Beispiel: Aus mehreren unabhängig bestätigten Erfahrungen kann EVE ableiten, welche Teile einer Formulierung die Ressource und welche die Aktion bestimmen.
Für eine freigegebene Hypothese fordert die aktuelle Konfiguration mindestens zwei unabhängige Herkunftswurzeln, unterschiedliche Begleitwerte und passende Kontraste sowie keine Gegenbeispiele. Ein Befund aus derselben Ursprungsquelle zählt nicht durch Wiederholung als neue unabhängige Unterstützung. Abgeleitete Kompositionen werden mit ihrer Herkunft geführt.
Ein Vorschlag entsteht nur aus ausreichend belegten Feldern und passender Provider-, Kontext- und Planstruktur. Fehlende Belege, Gegenbeispiele, Mehrdeutigkeit oder eine unvollständige Auswertung führen zum Fallback. Im aktuellen nativen Pfad wird ein gefundener Plan dem Modell als Erfahrung vorgelegt.
Exakt: Formulierung und erforderlicher Kontext passen zu einer nutzbaren Erfahrung.
Dynamisch: „Küche Licht an“ wird der bestätigten Erfahrung „Licht Küche an“ zugeordnet. Dieselben Wörter in anderer Reihenfolge führen zum vorhandenen Handlungsbezug: light.turn_on für light.kueche.
Komposition: „Licht Küche aus“ ist noch keine gespeicherte Erfahrung. Sind „Küche“ → light.kueche und „aus“ → light.turn_off unabhängig ausreichend belegt, setzt EVE daraus den neuen Planvorschlag zusammen.
Alle drei liefern im aktuellen nativen Ablauf Kontext für das Modell, keine automatisch abgespielte Befehlsfolge.
semantic_learning: Das laufende Modell kann ausgeführte Aktionen als strukturierte Erfahrungen speichern, explizite Sprachbeziehungen anlegen und korrigieren sowie frühere Vorgänge bestätigen oder widerlegen. Dazu lädt es den Werkzeugvertrag. Es gibt keinen zusätzlichen Planer und keine Erweiterung des Kernprompts.learned_action_experience. Das Modell entscheidet über die aktuellen Werkzeuge. Abgeleitete Wiederverwendung zählt nicht als neue unabhängige Grundlage derselben Komposition.Aktueller Umfang: Aktionserfahrungen sind für Home-Assistant-Dienstaufrufe über HTTP oder WebSocket mit ausdrücklich angegebenen Entitäts-IDs angebunden. Bereichs- und Geräteziele benötigen noch eine belegte Auflösung zu Entitäten. Für Shell, Web, Nova und Arbeitslisten existiert diese Aktionsprojektion derzeit nicht.
Der Schreibvertrag ist verfügbar; das Modell entscheidet, wann es ihn nutzt. Nicht jeder Turn erzeugt automatisch eine semantische Erfahrung. Das allgemeine Gesprächslernen im Hintergrund bleibt ein eigener Lernweg.
Brainwatch ist EVEs Oberfläche zum Erkunden und Prüfen ihres Gedächtnisses. Du kannst von einer Übersicht bis zu einer einzelnen Aussage, ihren Belegen und den zugehörigen Ereignissen gehen. Die folgenden Screenshots zeigen den tatsächlichen lokalen Stand vom 21.10.2026; Bestände und Zähler verändern sich mit der weiteren Nutzung.
Im Memory Explorer steht jeder Punkt für einen gespeicherten Claim. Verbindungen stehen für gespeicherte Relations, etwa eine Verfeinerung oder einen Widerspruch. Die Farblegende hilft bei der Einordnung. Suche, Scope, Claim-Art und Lifecycle grenzen den angezeigten Bestand ein. Kandidaten, aktive, abgelöste und ungültige Aussagen lassen sich so getrennt untersuchen.
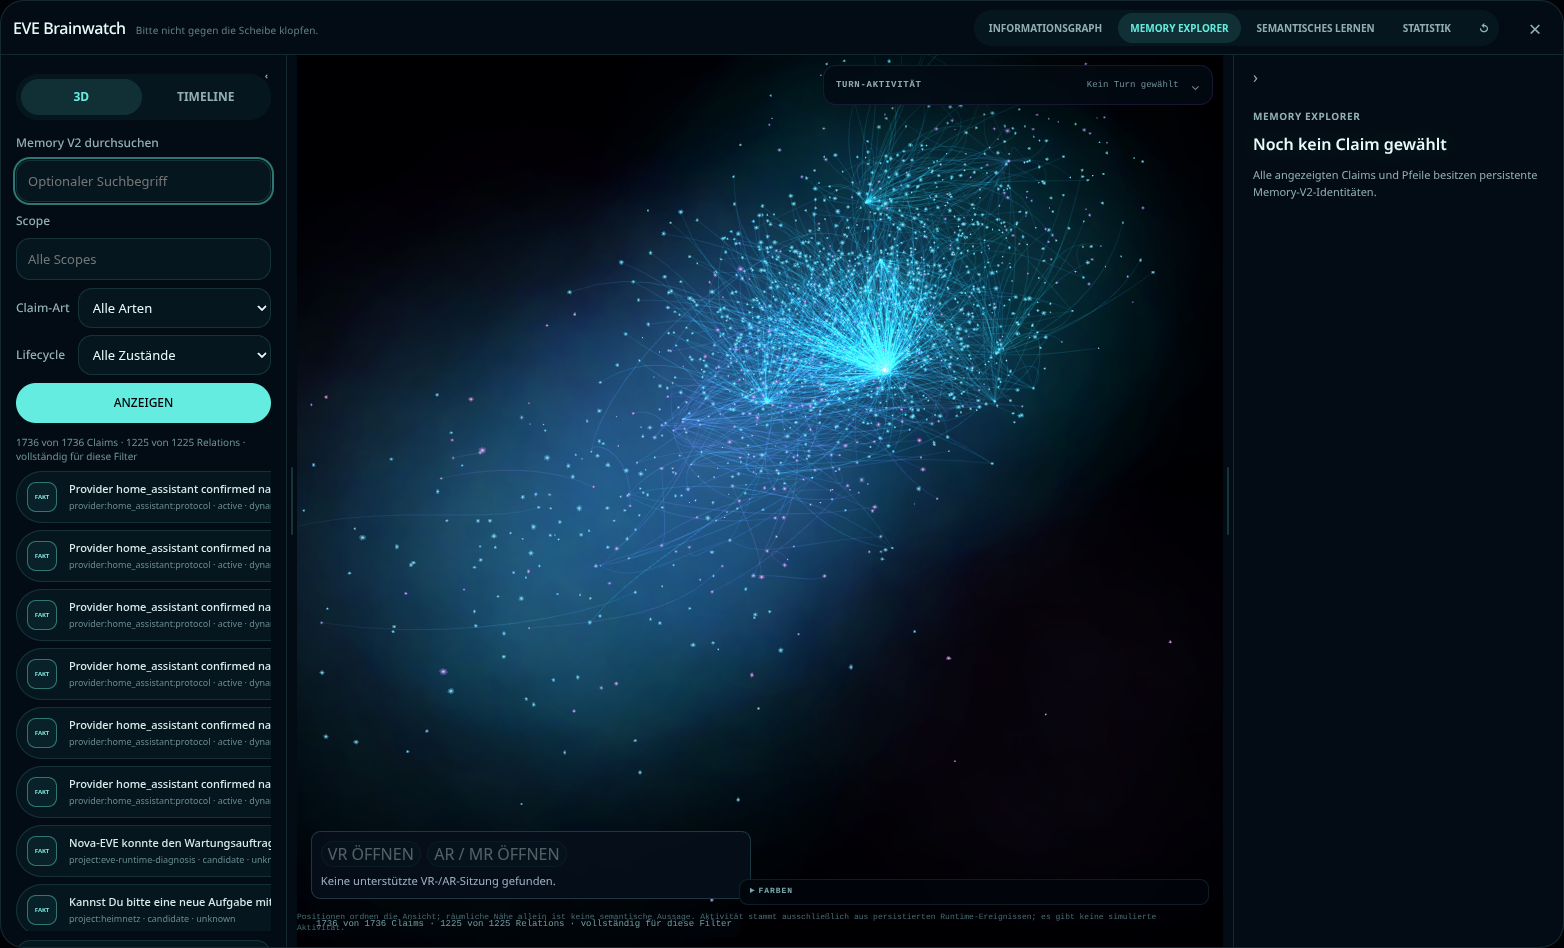
Ein Klick auf einen Claim öffnet rechts den Inspektor. Die Ansicht lässt sich drehen und vergrößern; mit einer unterstützten Brille kann derselbe Graph auch in VR oder AR/Mixed Reality erkundet werden. Die räumliche Anordnung dient der Übersicht: Nähe allein belegt keine Bedeutungsähnlichkeit. Auch die Wolke selbst ist kein Abbild der Modellgewichte.
Der Inspektor zeigt die stabile Claim-ID, Claim-Art, Scope, Lifecycle, Prüfpolitik, Zeitangaben sowie Belege und Relations. In den weiteren Details lassen sich die gespeicherten Nutzdaten und die Herkunft untersuchen. Damit lässt sich unterscheiden, ob eine Aussage beispielsweise aus einer Nutzernachricht, einer inventarisierten Ressource oder einem Werkzeugergebnis stammt.
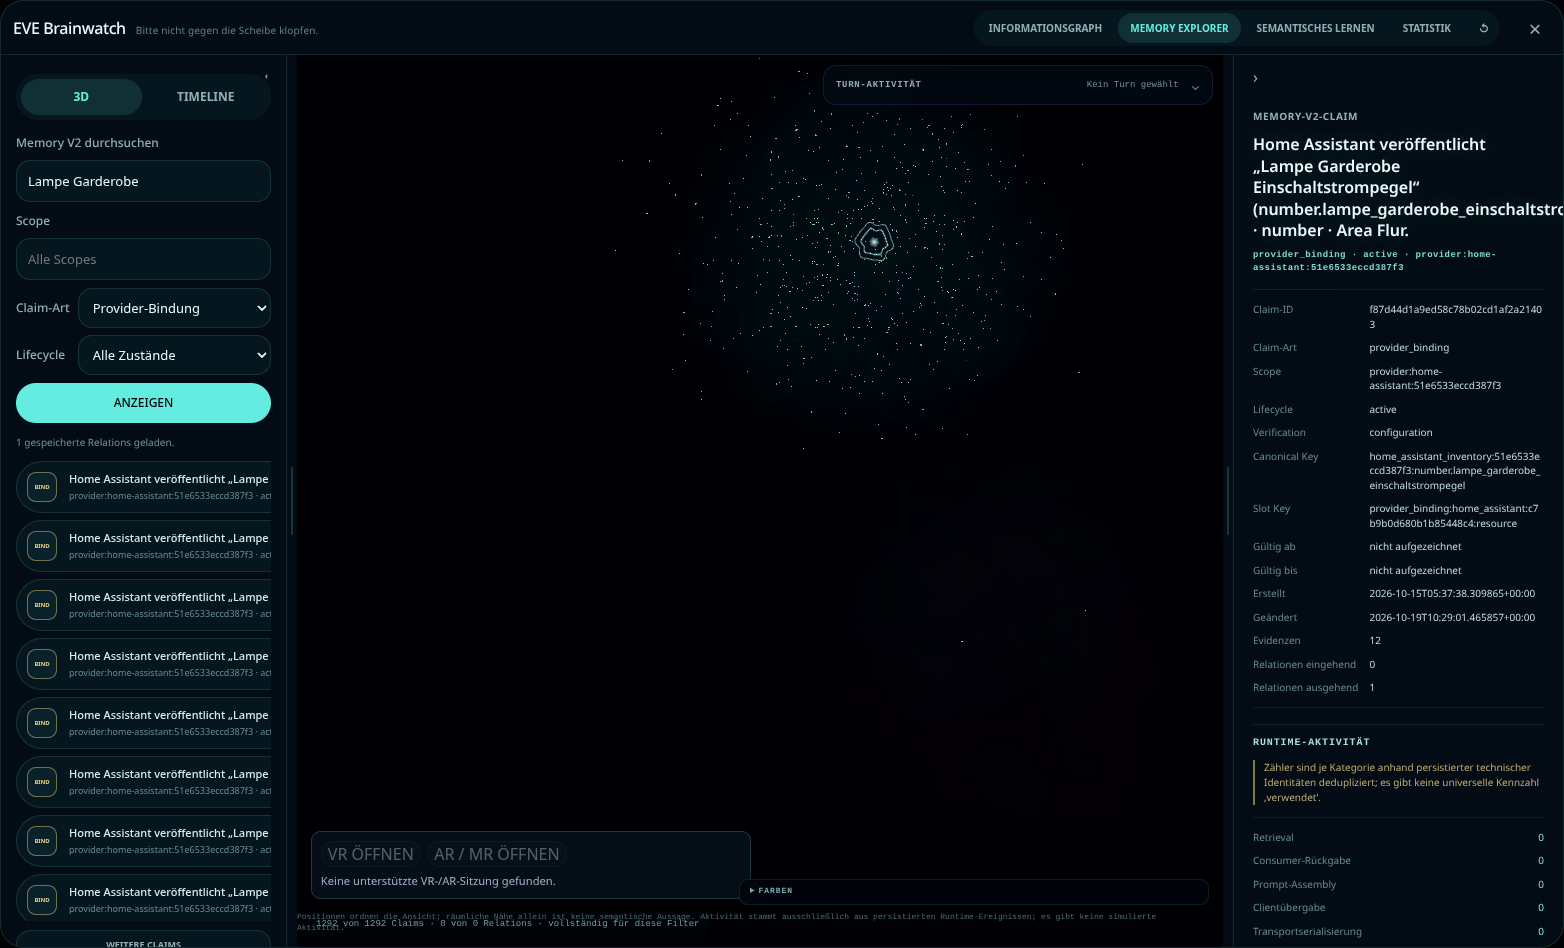
Die Runtime-Aktivität unterscheidet einzelne technische Stationen, etwa Retrieval, Kontextzusammenstellung und Übergabe an den Modellclient. Ein Suchtreffer allein belegt noch keine Verwendung durch das Modell. Für die Frage „Was wurde in diesem Turn tatsächlich bereitgestellt?“ müssen die passenden Vorgangsreferenzen und aufgezeichneten Stationen geprüft werden.
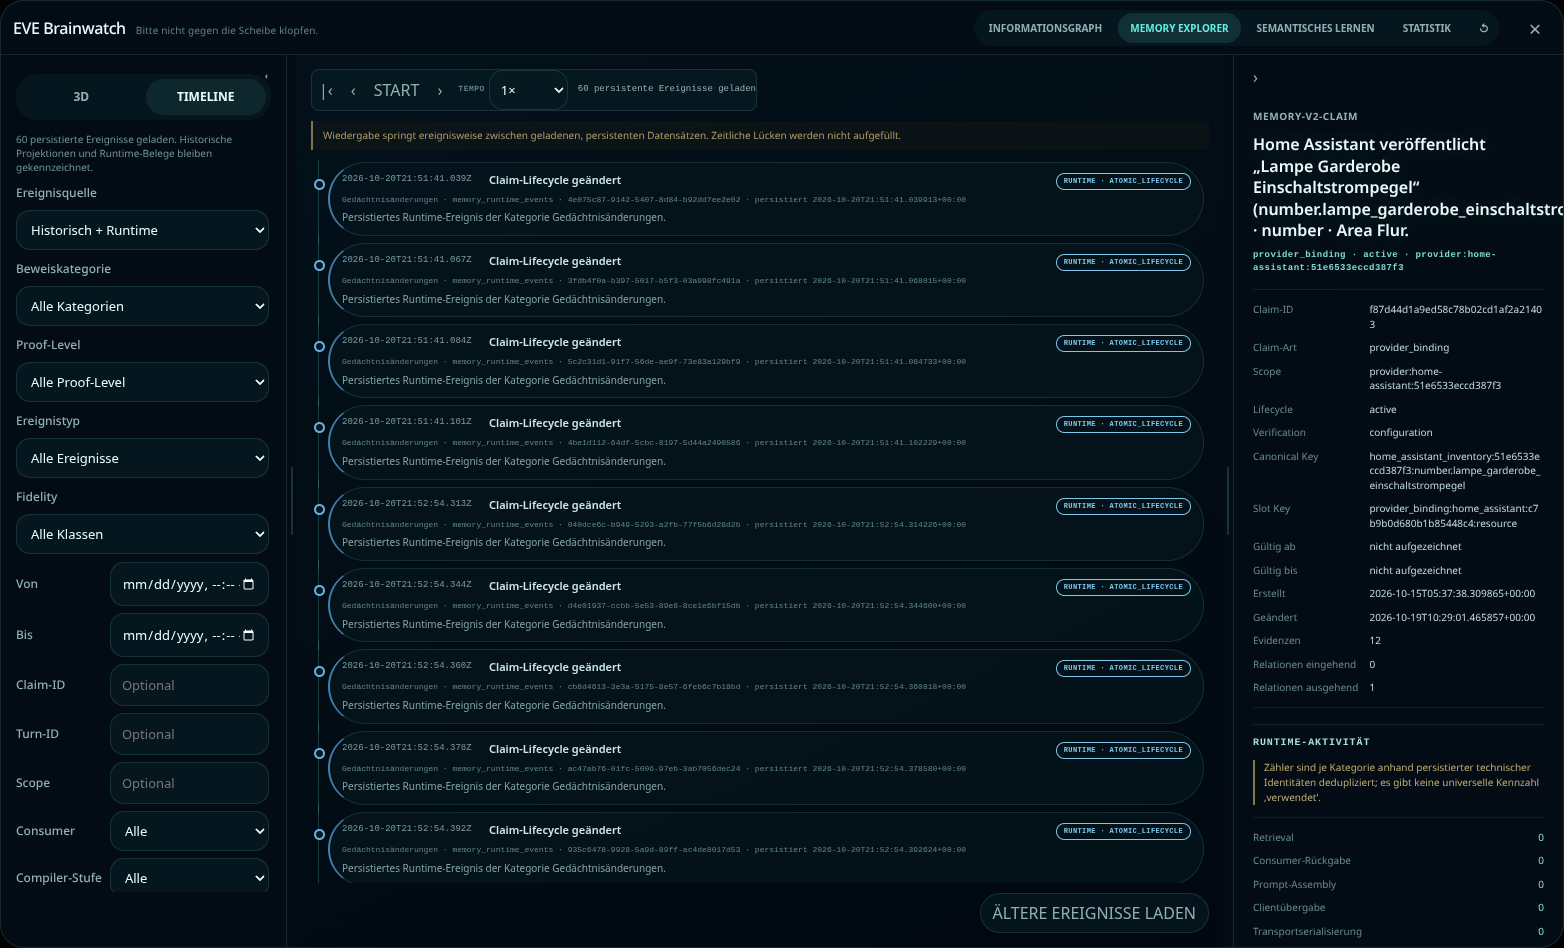
Die Timeline ordnet persistierte Ereignisse zeitlich ein: etwa die Anlage eines Claims, neue Evidence, Gedächtnisänderungen oder protokollierte Abrufe. Über Claim-, Turn- und Trace-ID sowie Kategorie, Ereignistyp und Proof-Level kann eine Untersuchung eingegrenzt werden. Historisch abgeleitete Einträge und direkte Runtime-Belege bleiben gekennzeichnet.
Dieser Bereich verbindet gelernte Formulierungen mit gemeinsamen Handlungen. Mehrere Sätze können derselben Handlung zugeordnet sein. Die Übersicht trennt bekannte Handlungen, verknüpfte Formulierungen, noch zu prüfende Erfahrungen, Bestätigungen, Widersprüche und zurückgewiesene Erfahrungen.
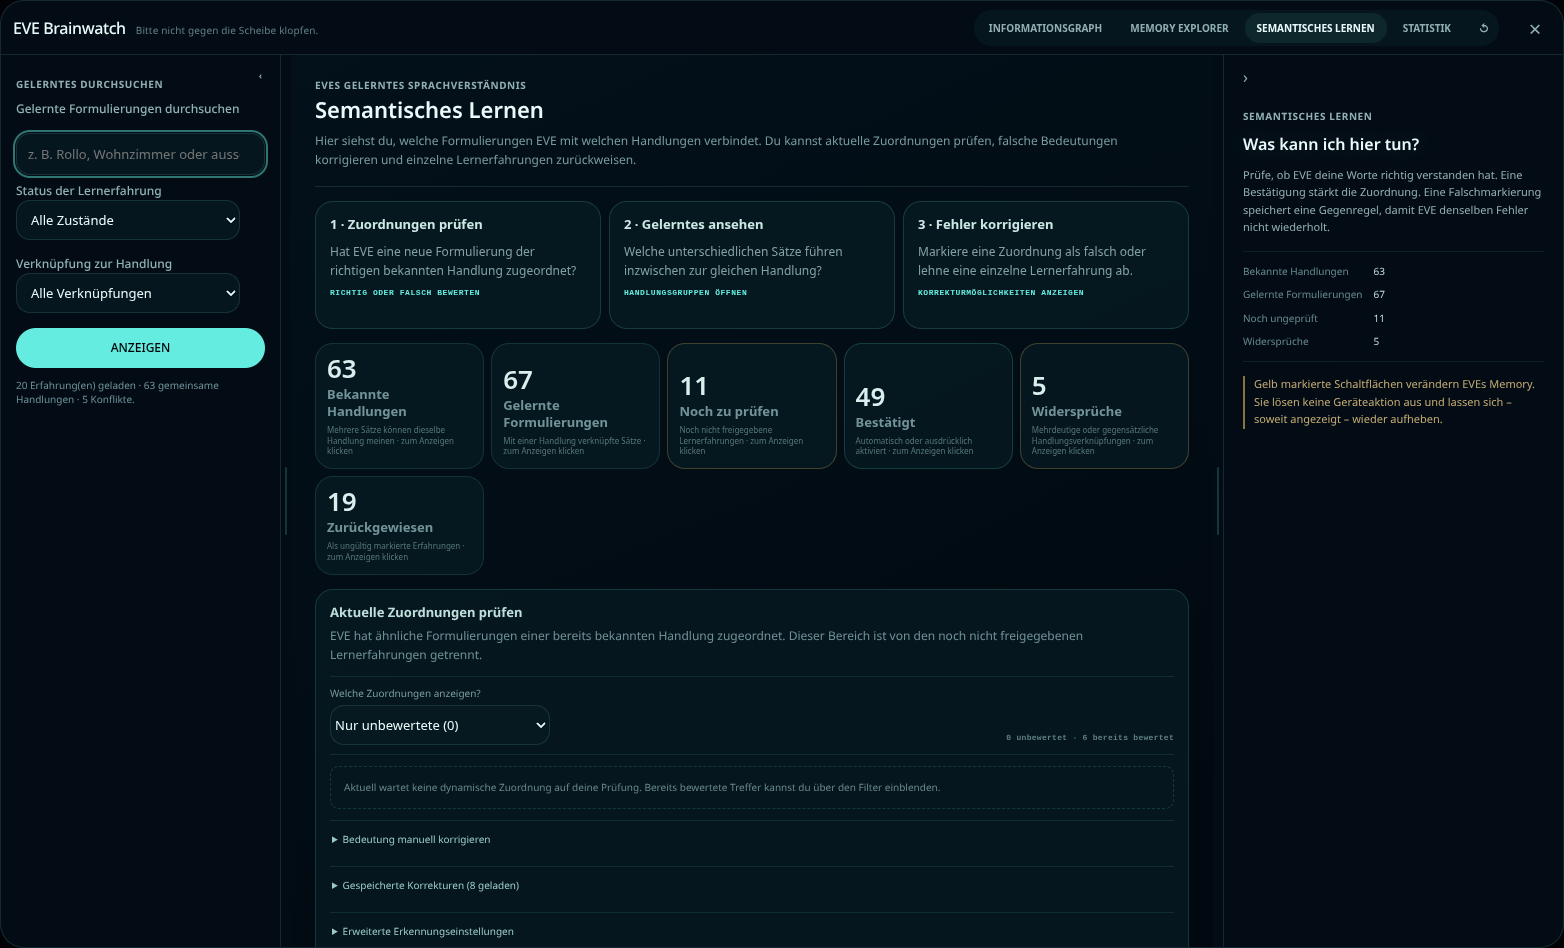
Eine Zuordnung kann als richtig oder falsch bewertet, eine einzelne Erfahrung zurückgewiesen und eine gespeicherte Bewertung gegebenenfalls aufgehoben werden. Die erweiterte Diagnose zeigt außerdem kompositionelle Hypothesen, Kontraste, Herkunft und fehlende Belege. Diese Bewertungen ändern das Gedächtnis; sie lösen keine erneute Geräteaktion aus. „Bestätigt“ kann dabei ausdrücklich oder automatisch bestätigt bedeuten.
Die Statistik zählt persistierte Datenbankeinträge: unter anderem Claims, Relations, Provider-Ressourcen, Werkzeugereignisse und aufgezeichnete Memory-Aktivität. Ein großer Bestand beschreibt zunächst die Menge des gespeicherten Materials. Ob eine bestimmte Erinnerung korrekt und hilfreich ist, zeigen erst ihre Belege und ihr Einsatz im konkreten Vorgang.
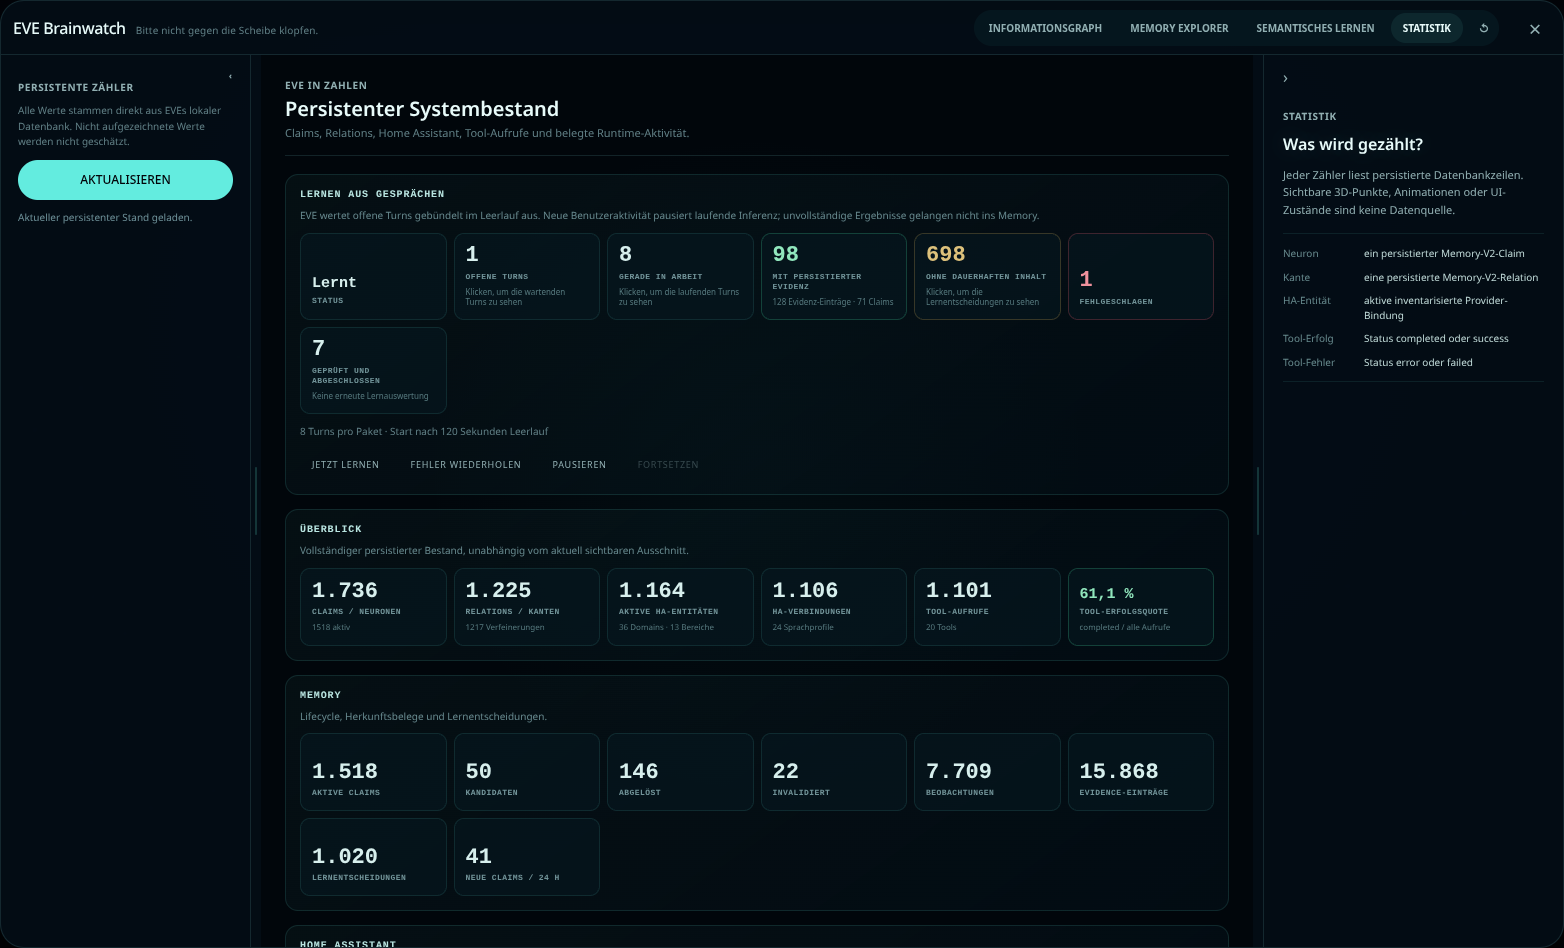
Die Lernübersicht zeigt außerdem abgeschlossene und fehlgeschlagene Lernaufträge. Bei einem Fehler lassen sich der ursprüngliche Vorschlag und die Fehlermeldung untersuchen. Nach tatsächlicher Prüfung kann der Vorgang mit einer Prüfnotiz als „geprüft“ abgeschlossen werden. Er wird dann nicht erneut automatisch zum Lernen eingereiht, bleibt aber nachvollziehbar und kann wieder geöffnet werden.
Die Begriffe sind alphabetisch geordnet. Die Erklärungen beziehen sich auf ihre Verwendung in EVE.
Die Darstellung beschreibt Implementierung und konfigurierte Werte, keine Garantie für jede Modellentscheidung. Historische Architekturtexte wurden mit dem aktuellen Einstiegspfad abgeglichen. Für diese Zusammenfassung wurde kein produktiver Lernlauf ausgelöst und kein Gedächtniseintrag verändert.
minimal.py · nativer Turn, Memory-Kontext und semantischer Lookupworking_context.py / working_memory.py · Originale, Checkpoints, Kontextwechsel, Bereinigungmemory_v2.py / memory_compiler.py · Wissenssichten und allgemeine Anweisungenconversation_learning.py · Leerlaufkoordinatorshadow_learning.py / learning_contract.py · produktives Lernen und Belegvertragnative_semantics.py · nativer Schreibvertrag und Prüfung der Ausführungsbelegesemantic_links.py · Aktionserfahrungen, Sprachbeziehungen, Ähnlichkeit und Feedbackdifferential_semantics.py · Hypothesen, Kontraste und Kompositionagent.py / cli.py · Einstieg, Persistenz und aktive Anbindungen